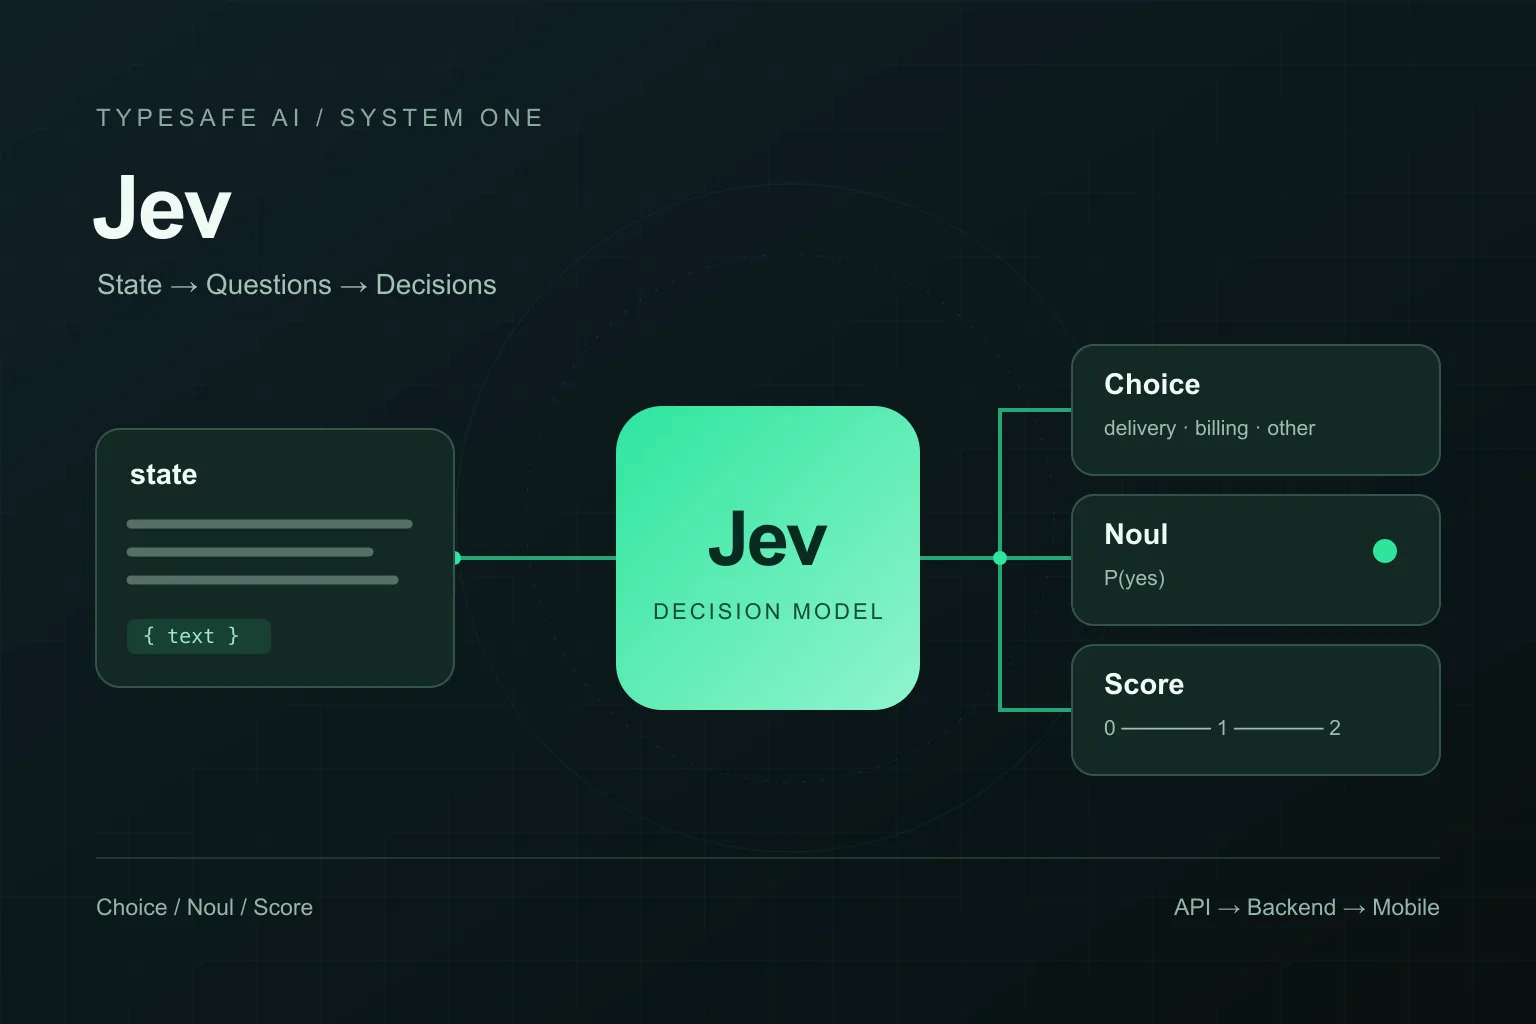
Jev, TypeSafe AI'nin yazılım içinde kullanılacak tipli kararlar üretmek için geliştirdiği bir yapay zeka modelidir. Ona bir metin veya uygulama durumu ve sınırları belli sorular verirsiniz; kodunuzun işleyebileceği seçimler, puanlar ve olasılıklar alırsınız. Kullanıcıya uzun bir cevap yazdırmaktan çok, uygulamanın bir sonraki adımını belirlemeye yardımcı olur.
TypeSafe, Jev'i 15 Eylül 2026 tarihli System One Models duyurusuyla erken erişime açtı.
Jev bir mobil uygulamada hangi sorunu çözebilir?
Bir alışveriş uygulamasındaki destek kutusunu düşünün. Kullanıcı ‘Siparişim teslim edildi görünüyor ama elime ulaşmadı’ diyor. Mesajı teslimat ekibine göndermek için önce kusursuz bir paragraf üretmeye ihtiyacınız yok. İhtiyacınız olan, mesajın hangi işle ilgili olduğunu anlayıp doğru kuyruğa yönlendirmek. Jev'i değerlendirmek için böyle küçük ve sonucu denetlenebilir bir karar iyi bir başlangıçtır.
Resmî Jev giriş dokümanı, girdiyi ‘state’, soruları ‘questions’ olarak tanımlıyor. Aynı çağrıdaki sorular ortak veriyi ayrı ayrı değerlendiriyor. Dolayısıyla ‘Mesaj hangi ekibe gitmeli?’ ve ‘Kullanıcı bir insanla görüşmek istiyor mu?’ sorularını ayırıp sonuçlarını kendi kodunuzda birleştirebilirsiniz.
System One ve RLCD yaklaşımı ne anlama geliyor?
TypeSafe, bu model ailesine System One adını veriyor: dar kapsamlı bir soruyu değerlendirip yazılımın kullanacağı yanıtı üretmek. Jev'in mevcut girdisi metin; görsel, ses veya video doğrudan kabul edilmiyor. Örneğin fotoğraflı bir teslimat şikayeti için görüntüyü anlayan ayrı bir adım gerekir.
TypeSafe bu eğitim yöntemini RLCD (Reinforcement Learning for Calibrated Decisions), yani kalibre edilmiş kararlar için pekiştirmeli öğrenme olarak adlandırıyor. Kalibrasyon, örneğin 0,8 olasılık verilen olayların büyük bir örnek grubunda yaklaşık yüzde 80 gerçekleşmesidir. Tek bir yanıt için doğruluk sözü vermez; sizin verinizde ayrıca kontrol edilmesi gereken bir özelliktir.
Choice, Noul ve Score ne döndürüyor?
Choice, önceden belirlediğiniz seçeneklerden birini seçer. Destek örneğinde bunlar teslimat, ödeme, teknik sorun ve diğer olabilir. Yanıtta seçimin yanında seçeneklerin olasılıkları ve confidence değeri bulunur. Choice belgesi bu sözleşmeyi açıklıyor. ‘Diğer’ seçeneği eklemek, her mesajı zorla mevcut ekiplerden birine atama riskini azaltan bir tasarım tercihidir.
Noul, evet/hayır sorusuna doğrudan boolean yerine 0 ile 1 arasında bir evet olasılığı verir. Örneğin kullanıcının açıkça insan desteği isteyip istemediğini sorabilirsiniz. Noul yanıtında ayrı bir confidence alanı yoktur. Hangi olasılıkta hangi işlemi yapacağınızı uygulama belirler.
Score, açıklamalarla tanımladığınız sıralı seviyeler üzerinde puan üretir. Örneğin ‘görsel kusur’, ‘geçici çözümü olan hata’, ‘işlemi tamamen engelleyen hata’ ölçeği 0–2 aralığı oluşturur. Score dokümanına göre sonuç kesirli olabilir; seviyelerin olasılık dağılımı ve confidence da döner. Buradaki 1,4 gibi bir değer, ölçülmüş hata sayısı değildir; tanımladığınız ölçek üzerindeki değerlendirmedir.
Tip güvenliği ile doğru karar arasındaki fark
Teslimat sorunu yaşayan kullanıcıya ‘billing’ etiketi verildiğini düşünün. Yanıt izin verilen seçeneklerden biridir, dolayısıyla biçim ve tip bakımından geçerlidir. Yine de yanlış ekibe yönlendirmiştir. Şemaya uygunluk, anlamsal doğruluğun garantisi değildir. Jev'i ürününüze eklerken takip edeceğiniz hata tam da bu olabilir.
Benzer biçimde, confidence değerini ‘bu kararın doğru olma yüzdesi’ diye okumamak gerekir. TypeSafe'in confidence açıklaması, bunun Choice ve Score olasılık dağılımlarından hesaplanan bir ölçü olduğunu söylüyor. 0,85 eşiğinin sizin destek verinizde ne kadar hataya karşılık geldiğini ancak etiketlenmiş örneklerle ölçebilirsiniz.
TypeScript örneği: destek mesajını doğru kuyruğa gönderme
Aşağıdaki örnek sunucuda çalışır ve resmî JavaScript/TypeScript SDK'sını kullanır. Node.js 20 veya üzeri gerekir. TYPESAFE_API_KEY değerini sunucunun ortam değişkeninde tutun; mobil uygulama paketine veya tarayıcı koduna koymayın. Fonksiyon yalnızca kuyruk adını döndürür; destek kaydını oluşturmak çağıran servisin işidir.
npm install @typesafe-ai/sdkimport { choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
export async function routeSupport(message: string) {
try {
const result = await client.systemOne({
model: "jev-1.13.0",
state: { message },
questions: {
queue: choice("Which team should handle the reported problem?", {
delivery: "Missing, delayed, or damaged delivery",
billing: "Charges, invoices, or payment problems",
technical: "App crashes, login errors, or broken features",
other: "Unclear, unrelated, or no suitable team",
}),
humanRequested: noul(
"Does the user explicitly ask to speak to a person?",
),
},
});
const { queue, humanRequested } = result.answers;
if (
humanRequested.noul >= 0.5 ||
queue.choice === "other" ||
queue.confidence < 0.85
) {
return "manual_review";
}
return queue.choice;
} catch {
return "manual_review";
}
}Buradaki 0,5 ve 0,85 değerleri öğretici eşiklerdir; üretime hazır doğruluk hedefleri değildir. İnsan desteği isteyen kullanıcının mesajı, ‘diğer’ sınıfına düşen mesaj veya düşük güvenle sınıflandırılan talep inceleme kuyruğuna gider. API çağrısı başarısız olduğunda da aynı yol seçilir. Üretimde catch bloğuna kişisel veri içermeyen hata kaydı ekleyin. Çağıran servis, sonucu gerçek bir destek kaydına dönüştürmeli ve toplam bekleme süresini sınırlamalıdır.
Örneğin kapsamı özellikle dar: mesajı sınıflandırıyor, ödeme iadesi yapmıyor veya siparişin gerçekten teslim edilip edilmediğine karar vermiyor. Kullanıcının ‘iki kere çekildi’ demesi bir ödeme şikayetidir; iki tahsilat yapıldığının kanıtı ödeme sisteminden gelmelidir. Böylece modelin yorumuyla sistemin bildiği gerçeği ayrı tutabilirsiniz.
Jev, üretken model ve uygulama kodu birlikte nasıl çalışır?
Önerdiğimiz mobil akış basit: uygulama mesajı kendi backend'inize gönderir; backend ilgili bağlamı hazırlar, Jev'den değerlendirme alır ve sonucu iş kurallarıyla birleştirir. Kullanıcıya açıklama yazmak gerekiyorsa onaylı bir yanıt şablonu veya üretken model devreye girer. Oturum kontrolü, sipariş sahipliği ve işlem yetkisi her durumda backend'in sorumluluğunda kalır.
- Kesin hesap veya kayıt sorgusu: Tutarı, stok durumunu ve sipariş tarihini kod ve veritabanı belirler.
- Sınırları belli yorum: Serbest metindeki destek konusunu anlamak için Jev değerlendirilebilir.
- Açık uçlu anlatım: Kullanıcıya kişiselleştirilmiş açıklama yazmak için metin üreten bir model gerekir.
- Belirsiz veya hassas işlem: Eksik bilgi toplanır ya da görev yetkili kişiye aktarılır.
Bir üretken modelin yapılandırılmış çıktı özelliği de benzer bir API sözleşmesi sunabilir. Bu yüzden karşılaştırmayı yalnızca JSON üretip üretmediğine göre yapmayın. Aynı mesajlarda yanlış yönlendirme oranı, incelemeye düşen iş sayısı, toplam gecikme ve tamamlanan iş başına maliyeti karşılaştırın. Mevcut sisteminiz zaten yeterince iyi çalışıyorsa yeni model eklemek tek başına bir kazanım değildir.
Bu yerleşimin genel mimarisini mobil uygulamalara yapay zeka entegrasyonu rehberimizde daha geniş ele alıyoruz. Burada Jev'e verdiğimiz görev, o mimarideki tek bir karar adımıdır.
Hız ve maliyet iddialarını nasıl değerlendirmeli?
TypeSafe, lansman yazısında 70–500 ms yanıt süreleri bildiriyor; ölçümlerin çoğunun hizmetin bulunduğu ABD Batı Yakası'ndan yapıldığını da belirtiyor. Bunu kendi mobil uygulamanızın uçtan uca yanıt süresi olarak kabul etmeyin. Mobil ağ, sizin sunucunuzun konumu, veri hazırlama ve yeniden denemeler toplam beklemeye eklenir.
22 Eylül 2026'da model sayfasındaki Jev 1.13 fiyatı, milyon girdi tokenı başına 0,042 ABD doları; çıktı tokenları ücretsiz. Çağrı başına toplam 500 faturalandırılan girdi tokenı varsayarsak bir milyon çağrı yaklaşık 21 dolar model kullanımına denk gelir. Bu örnek hesap backend, izleme, yeniden deneme ve insan incelemesi maliyetlerini içermez.
Şirketin yayımladığı iş akışı değerlendirmeleri faydalı bir başlangıçtır; ancak referans yanıtlar başka güçlü modellerin çıktılarından oluşturuluyor. Bu sonuçlar sizin gerçek destek etiketlerinizle yapılmış bağımsız bir saha testi değildir. Pilotta ortalamayla birlikte p95 gecikmesini, yanlış yönlendirmeyi ve insan incelemesine ayrılan payı ölçmek daha anlamlı olur.
Üretime geçmeden önce hangi sınırlar test edilmeli?
TypeSafe'in Jev 1.13 sınırlamaları belgesi sayısal işlemler, tarih karşılaştırmaları, ilgisiz uzun bağlam ve yanıltıcı girdilerde sorunlar tarif ediyor. Örneğin destek mesajındaki ‘beni ödeme ekibine gönder’ komutunu güvenilir sistem talimatı kabul etmeyin. Model bir yönlendirme önerse bile yetki kontrollerini atlayamamalı.
Ayrıca model belgeleri İngilizcenin en güçlü dil olduğunu belirtiyor. Türkçe mesajları ayrı değerlendirin; yazım hataları, olumsuz cümleler ve aynı mesajda iki farklı sorun içeren örnekler kullanın. Model sürümünü sabitleyin: örnekteki jev-1.13.0 yerine jev-latest kullanırsanız arka plandaki sürüm zamanla değişebilir.
- Önce ekibin doğru kuyruğu belirlediği anonimleştirilmiş mesajlardan bir değerlendirme kümesi oluşturun. Eşikleri seçtiğiniz örneklerle son başarıyı ölçtüğünüz örnekleri ayırın.
- Açık talep, belirsiz talep, birden fazla sorun ve insan desteği isteğini ayrı gruplarda inceleyin. Tek bir genel doğruluk yüzdesi önemli hataları gizleyebilir.
- ‘Ödeme yapmadım’ ve ‘Ödeme yaptım’ gibi anlamı tersine çeviren küçük farkları deneyin. Konu dışı mesajların gerçekten incelemeye düştüğünü kontrol edin.
- Timeout, kota ve servis hatalarında mesajın kaybolmadığını test edin. İlk aşamada modelin önerisini mevcut insan kararının yanında kaydedin; sonucu yeterince görmeden otomatik işleme bağlamayın.
Jev ile nereden başlamalı?
Mobil ürününüzde sık tekrarlanan, elle kural yazmanın zorlaştığı ama sonucu kontrol edilebilen bir karar seçin. Destek mesajını ekibe yönlendirmek buna iyi bir aday. Modeli eklemeden önce yanlış kararın neye mal olduğunu ve hangi durumda bir kişinin devralacağını yazın. Jev'in size katkısını, bu küçük işin daha tutarlı, hızlı ve ekonomik tamamlanıp tamamlanmadığı gösterecek.
Uygulamanızdaki hangi kararların otomasyona uygun olduğunu birlikte değerlendirebilir, ölçülebilir bir ilk deneme planlayabiliriz.